
30份檔案作文一次改完!Codex批次處理怎麼做?用「批次流水線5元件」自動產出總表
需要大量處理30份作文、50張發票、200份履歷,還在一份一份丟給AI嗎?本文作者以批次「批改作文」為例,拆解「批次流水線5元件」,教你用Codex建立可重用的批次Skill,跑完自動產出彙整總表;文末也整理了發票、履歷、合約3種行業的改法,可以直接對照。本文節錄自《ChatGPT × Codex全攻略》。
文/曾慶良(阿亮老師)
本文目錄(點擊可快速前往)
目標:多檔案批次處理工作流
「把30-100個檔案丟到一個資料夾,告訴Codex動作,多核心並行跑、失敗自動重試、跑完丟出summary.xlsx」,這是學完本文後你的日常。
- 輸入:input/內30個.docx(或.pdf / .jpg)。
- 輸出:output/內30個結果檔 + logs/batch.log + summary.xlsx。
阿亮獨家「批次流水線5元件」:
批次讀取 → 並行 → 進度 → 重試 → 彙整5元件缺一不可。本文把它包成一個可重用的批次Skill,之後處理任何「N個檔案」需求,一句話就觸發。學完不只批改作文,發票OCR、履歷篩選、合約風險檢測都用同一套。
不同職業完成後能拿來幹嘛?
| 行業 | 批次任務 | 輸出 |
|---|---|---|
| 教師 | 30份.docx作文 → 評語 | 30個.md + summary.xlsx |
| SOHO | 50張發票.jpg → OCR | 50個.json + invoices.xlsx |
| HR | 200份履歷.pdf → 5維評分 | 每份.md + 通過/待面試/不通過名單 |
| 律師 | 50份合約.pdf → 風險條款 | 每份摘要 + 整體評估.xlsx |
動手做前準備清單
| 項目 | 規格 |
|---|---|
| Codex CLI | 已裝,Codex CLI 、桌面App |
| 原始檔案 | 30-100個同類檔案(.docx / .pdf / .jpg) |
| 檔案位置 | 全部放在同一個資料夾 |
| 單檔處理動作 | 清楚知道「對單檔要做什麼」 |
| Python套件 | concurrent.futures、pandas、依檔型python-docx / pypdf / Pillow(Codex自動裝) |
批次流水線5元件:缺一個就會出事
| 元件 | 做什麼 | 沒有的後果 |
|---|---|---|
| 1 批次讀取 | 掃描資料夾、過濾副檔名 | 漏檔、誤讀 |
| 2 並行 | 多核心同時處理 | 30份跑30倍時間 |
| 3 進度 | 每N份印一次「15/30」 | 不知道卡住還是在跑 |
| 4 重試 | 單檔失敗最多3次 | 1個壞檔讓整批停擺 |
| 5 彙整 | 個別輸出 + summary.xlsx | 30個檔不知道整體結果 |
兩種「並行」不要混為一談:
| 類型 | 工具 | 用在哪 | 並行單位 |
|---|---|---|---|
| Python腳本層並行 | concurrent.futures | 一支Python程式同時跑8個檔案 | OS執行緒/行程 |
| Codex對話層並行 | Codex內部subagents | 一個Codex任務fork多個subagent | LLM推理session |
本章用「腳本層並行」:對30個檔案跑同一個邏輯,每個檔案不需要獨立的LLM推理。如果每個檔案都用subagent跑,會吃掉30倍token,慢又貴。subagent留給「30篇論文同時做深度摘要」這類需要獨立思考的任務。
補充:2026新利器spawn_agents_on_csv
當你的任務確實需要「每一列開一個獨立分身去想」(例如30位學生各自寫一段深度個人化評語、300筆客戶各自產一份分析),Codex子代理人支援spawn_agents_on_csv,餵一份CSV,它會逐列派工給多個subagent,並可指定統一的輸出schema(設定寫在子代理人TOML)。判斷原則不變:同一套邏輯套N個檔 → 用本文的腳本層並行就好;每個檔要獨立思考 → 才動用spawn_agents_on_csv。
動手實作:多檔案批次處理工作流
步驟1:建環境
macOS / Linux:
mkdir -p ~/batch-work/{input,output,logs}
cd ~/batch-work
Windows PowerShell:
mkdir $HOME\batch-work\input
mkdir $HOME\batch-work\output
mkdir $HOME\batch-work\logs
cd $HOME\batch-work分成3個資料夾是好習慣:input只放原始檔(唯讀心態)、output只放結果、logs存執行紀錄,失敗時就知道去哪找錯誤。
手上沒有30份檔案可測?
也可以直接對Codex下指令:「幫我生30份500字模擬作文存成input/essay_01.docx ~ essay_30.docx,品質故意做出高中低差」。
把30個檔案丟進input/,注意3件事:
- 直接複製到input/,不要在裡面再分子資料夾,批次腳本預設掃單層
- 檢查副檔名一致(避免.docx跟.doc混在一起)
- 確認檔案數對:
macOS / Linux:
ls input/ | wc -lWindows PowerShell:
(dir input\).Count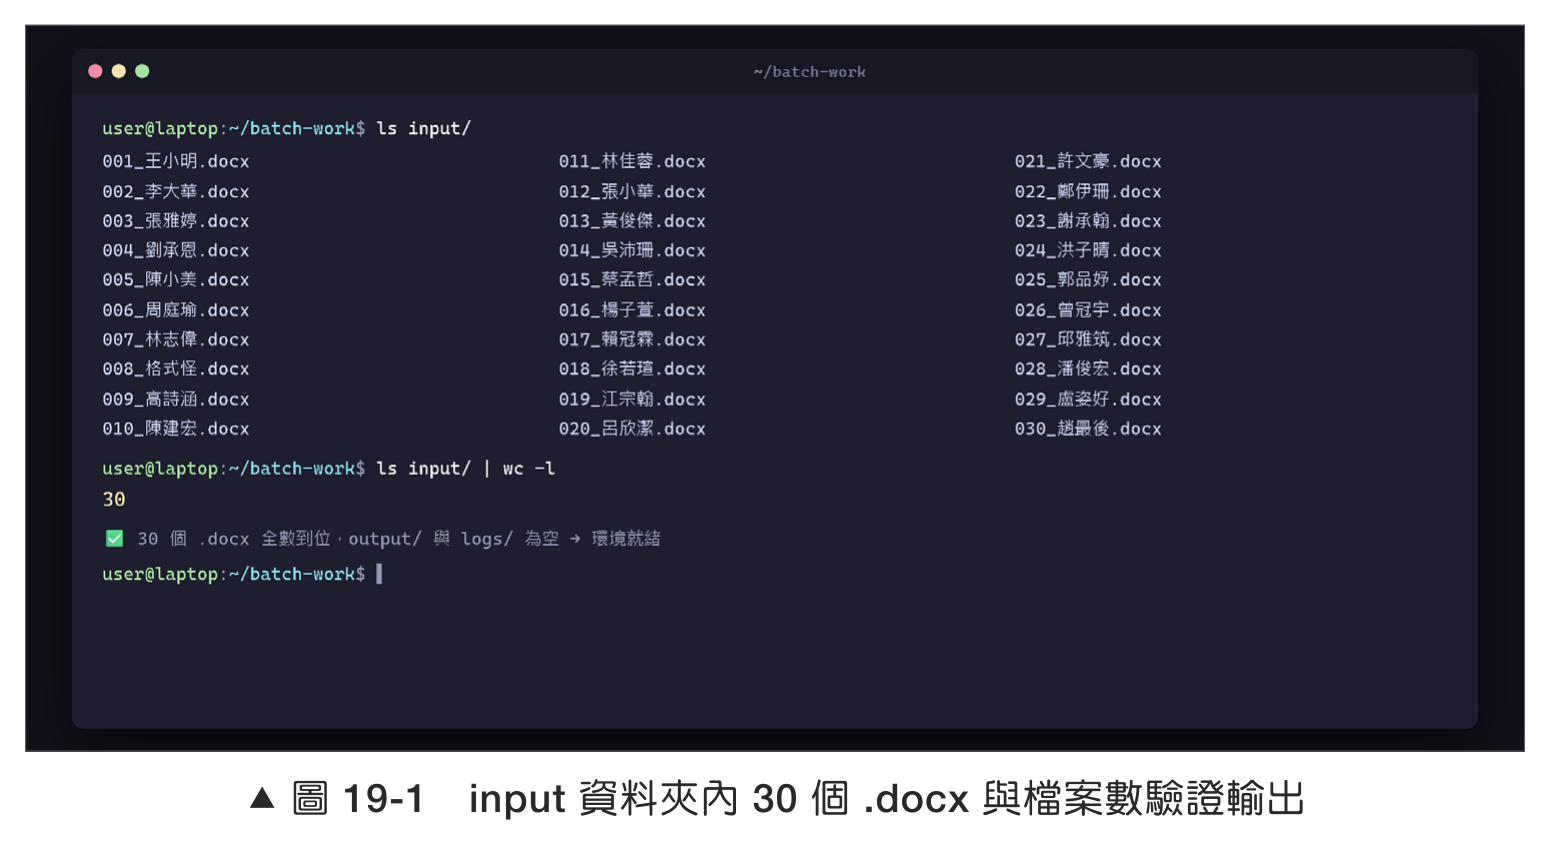
步驟1-1:先建essay-feedback Skill(批次要呼叫的單檔工具)
這裡最容易卡住:步驟3的批次prompt會「每份套用essay-feedback Skill」,所以這支Skill要先存在,批次才有東西可以呼叫。它就是把「三段式思考(CoT)」批改流程包成Skill的小工具,現在花5分鐘就能建好。
建立方式:先用下方指令開一個Skill資料夾,再用記事本或VS Code在資料夾裡新增SKILL.md,貼上下方「essay-feedback 隨書附檔」的完整內容:
# macOS / Linux
mkdir -p ~/.agents/skills/essay-feedback

# Windows PowerShell
mkdir $HOME\.agents\skills\essay-feedback
essay-feedback 隨書附檔:
---
name: essay-feedback
description: 批改一篇學生作文(.docx / .md / .txt)並產生 100-150 字個人化評語。觸發詞:作文批改、評語、essay feedback、作文評語產生器、批改作文。
---

# 作文評語產生器

## Steps

1. 讀入單一作文檔(純文字、不含格式)
2. **Stage 1 step-through**:
   - 字數統計(總字數 / 段落數)
   - 主旨抓取(一句話總結這篇在寫什麼)
   - 結構分析(起承轉合 / 論點論據 / 時序)
3. **Stage 2 self-audit**:
   - 列 3 個「寫得好的地方」(必須引用原文片段,不可空話)
   - 列 3 個「可改善的地方」(必須具體、可執行)
4. **Stage 3 final answer**:
   - 寫 100-150 字評語:肯定 1 個強項 + 建議 2 個改進 + 勉勵 1 句
   - 評語語氣:對國中小學生用鼓勵語氣;對高中以上用建設性語氣

## Rules

- MUST:評語必須引用作文原文(用「『...』」括起來,至少 1 處)
- MUST:建議必須可執行(「下次寫人物時可以加一個具體動作」而不是「加油」)
- MUST:字數 100-150(不可超過 150)
- NEVER:「同學們」「你們」「大家」(這是給個人的評語)
- NEVER:「應該」「必須」「一定要」(建議句改用「可以試試看」「下次或許」)
- NEVER:在沒讀作文的情況下產評語(空檔案直接回報「檔案無內容」)

## Output Format

```text
【評語】
(100-150 字評語段落)

【強項引用】
原文:「...」
評:(一句話說明為什麼好)

【改進建議】
1. (具體可執行)
2. (具體可執行)
```
核心是frontmatter的name: essay-feedback + description觸發詞,加上三段式批改流程與MUST/NEVER規則。
順帶一提,建立Skill有三種方式:$skill-creator引導式、macOS Codex App的Record & Replay錄製、手動建立資料夾,像這種內容已經寫好的小Skill,手動複製最快。
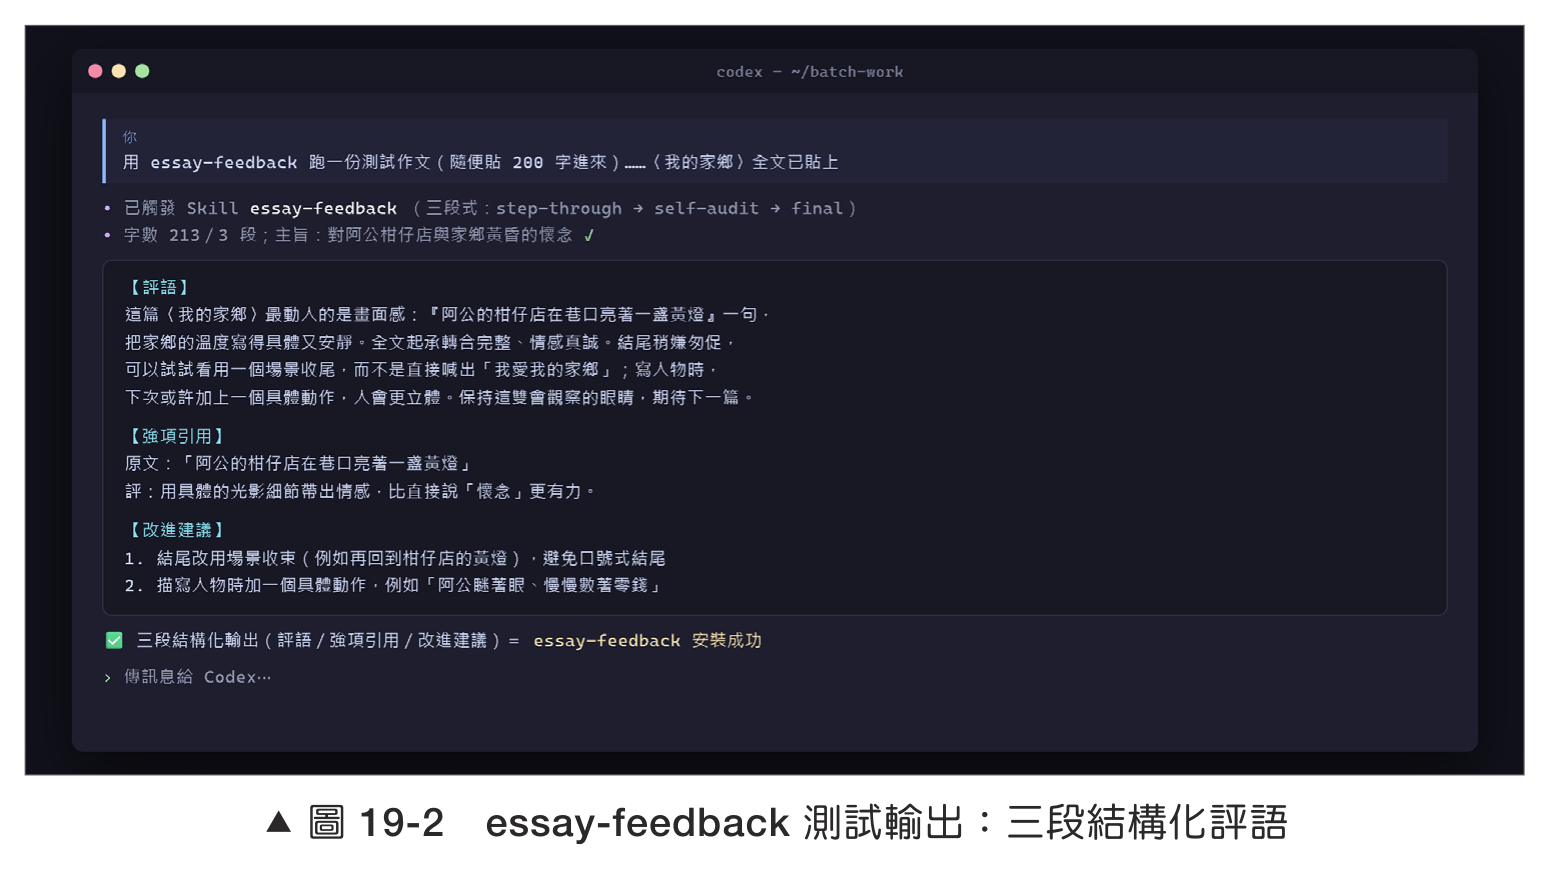
驗證有沒有生效,進Codex對話丟一句:
用 essay-feedback 跑一份測試作文(隨便貼 200 字進來)看到「【評語】【強項引用】【改進建議】」三段結構化輸出 = 安裝成功。
步驟2:寫批次Skill
用「批次作文批改」當範例。SKILL.md路徑:
~/.agents/skills/batch-grade-essays/SKILL.md(user級;若要團隊共用改repo級.agents/skills/...。)
完整內容:
---
name: batch-grade-essays
description: 對資料夾下所有 .docx 跑「作文評語產生器」並彙整 summary。當使用者說「批次批改」「批次作業」「整批評語」「資料夾批改」時觸發。
---

# 批次作文批改

## Steps
1. 掃描 ~/batch-work/input/ 下所有 .docx
2. 對每份:
   2.1 讀取內容(python-docx)
   2.2 套 essay-feedback(作文評語產生器)Skill
   2.3 輸出 ~/batch-work/output/[原檔名]_評語.md
   2.4 紀錄到 logs/batch.log
3. 並行處理(最多 8 個同時,依 CPU 核心數)
4. 失敗重試 3 次
5. 全完成產 summary.xlsx

## Rules
- MUST:每檔獨立處理(一份失敗不影響其他)
- MUST:失敗紀錄含原因(檔名 + 錯誤訊息)
- NEVER:跑到一半放棄整批
- NEVER:覆蓋 output 已存在的檔案(除非加 --force)
- SHOULD:每 5 份印一次進度
- SHOULD:跑完印「成功 X、失敗 Y、總耗時 Z」

## Tools(依檔案類型選用)
- .docx:python-docx
- .pdf:pypdf(純文字 PDF);掃描型 → pdfplumber 或先 OCR
- .jpg / .png:Pillow + pytesseract
- .xlsx / .csv:pandas + openpyxl
- 並行:concurrent.futures.ThreadPoolExecutor(I/O bound 如 OCR / API)
ProcessPoolExecutor(CPU bound 如純運算)- 註:
- I/O bound:卡在「等讀寫、等網路回應」的工作,例如OCR、呼叫API,適合用ThreadPoolExecutor。
- CPU bound:卡在「純算數」的工作,適合用ProcessPoolExecutor。分不清就先用ThreadPoolExecutor,本文的檔案處理多半屬前者。
Rules是Codex的「品管SOP」,寫得越明確,AI越不會偷工。
步驟3:跑批次
先搞懂機制,別被SKILL.md的「2.2套essay-feedback」誤導:Python腳本本身不能「呼叫」另一支Skill。真正的分工是,Codex在對話裡對每份檔案套essay-feedback產出評語,concurrent.futures這類腳本層並行只負責讀檔、寫檔、記log這種I/O苦力。所以下面「觸發批次Skill」時,是Codex逐檔重跑審文工作流,不是一支Python迴圈自己把評語生出來。要離線排程無人值守時,改用codex exec逐檔驅動。
觸發Skill:
請執行「批次作文批改」Skill:
- 輸入:~/batch-work/input/
- 輸出:~/batch-work/output/
- 並行數:8(4 核 CPU 改 4,看你機器)
- 每份套用:essay-feedback Skill
  (步驟 1-1 已建好 ~/.agents/skills/essay-feedback/)
- 每 5 份印進度並行數不要設太高:設16-32容易被OpenAI rate limit擋掉,或記憶體會爆掉。先設定4或8試試看。
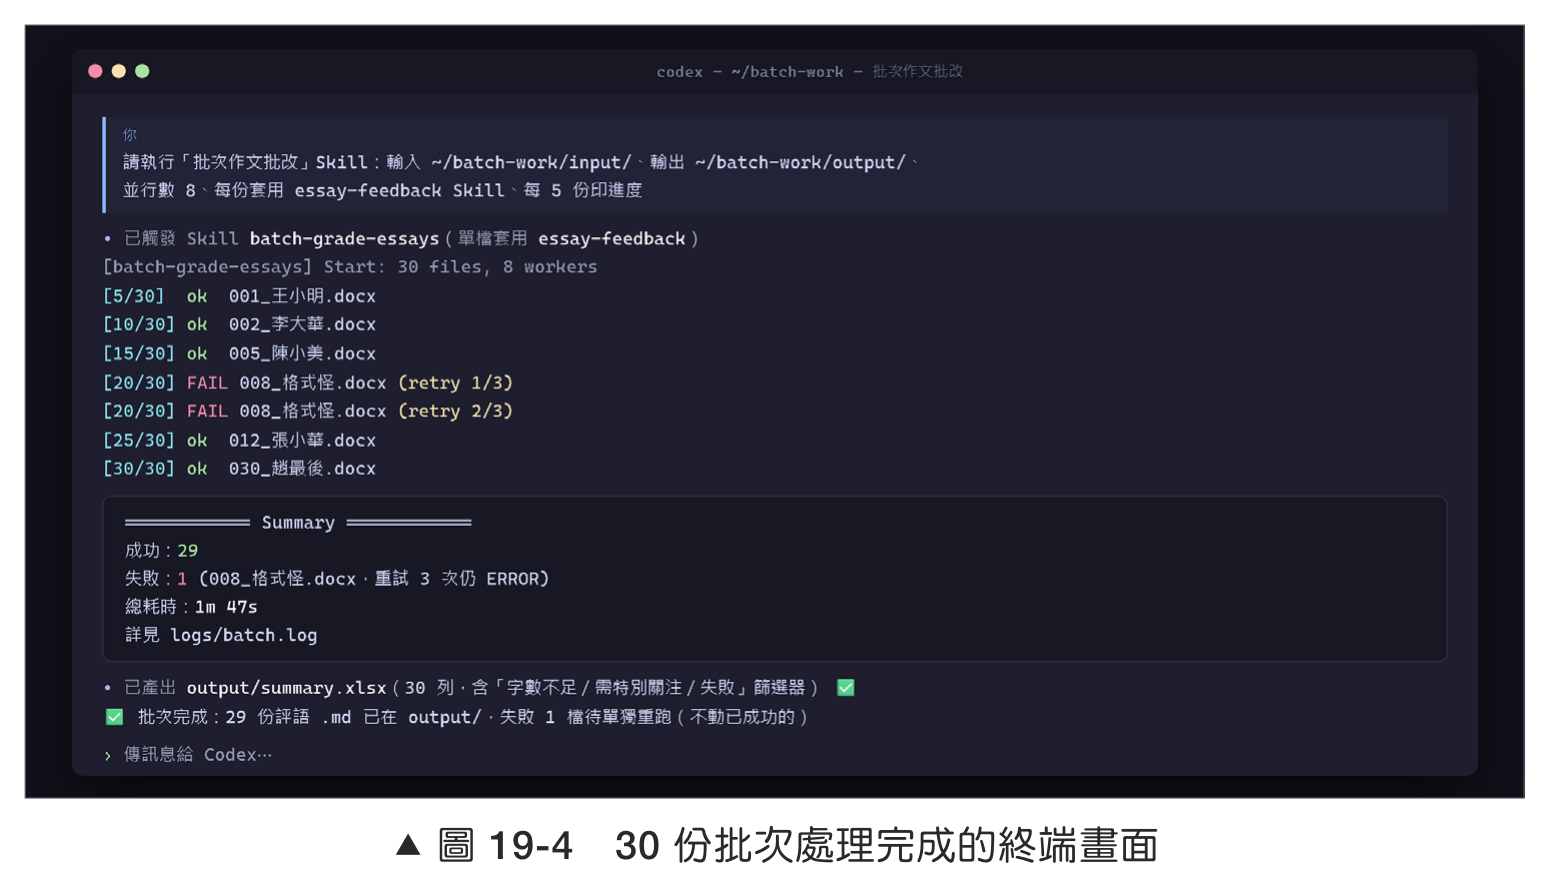
進度輸出長這樣:
[batch-grade-essays] Start: 30 files, 8 workers
[5/30]  ok  001_王小明.docx
[10/30] ok  002_李大華.docx
[15/30] ok  005_陳小美.docx
[20/30] FAIL 008_格式怪.docx (retry 1/3)
[20/30] FAIL 008_格式怪.docx (retry 2/3)
[25/30] ok  012_張小華.docx
[30/30] ok  030_趙最後.docx

============ Summary ============
成功:29
失敗:1 (008_格式怪.docx,重試 3 次仍 ERROR)
總耗時:1m 47s
詳見 logs/batch.log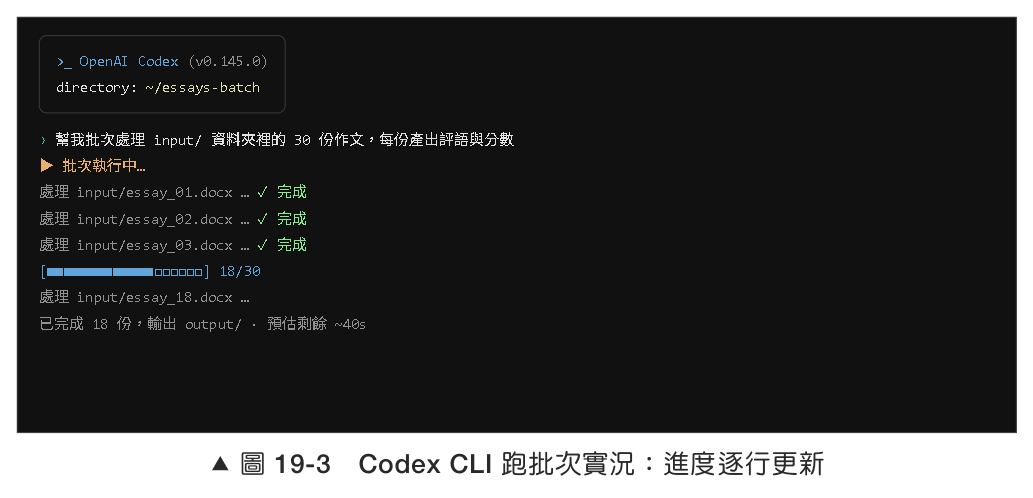
看到「成功X、失敗Y、耗時Z」三行 = 批次跑完,可以開始檢查失敗檔。
步驟4:驗收 + 處理失敗 + 彙整
數一下output:
macOS / Linux:
ls ~/batch-work/output/ | wc -l    # 預期 30(或 29 + 1 失敗)
grep "ERROR" ~/batch-work/logs/batch.log
Windows PowerShell:
(dir $HOME\batch-work\output\).Count
Select-String "ERROR" $HOME\batch-work\logs\batch.log
數對就代表正常。如果少了幾份,查看log內的ERROR,把失敗檔名抓出來。
處理失敗檔(不要整批重來):
請看 ~/batch-work/logs/batch.log,
找出標記 ERROR 的檔案與原因。

對每個失敗檔:
1. 顯示原因(檔案損毀、格式不支援、套件版本不對)
2. 提出對策(修檔、跳過、改規則)
3. 只重跑這幾個失敗檔,不要動已成功的請切記,不要整批重跑,因為已成功的會被覆蓋一次,浪費API額度。
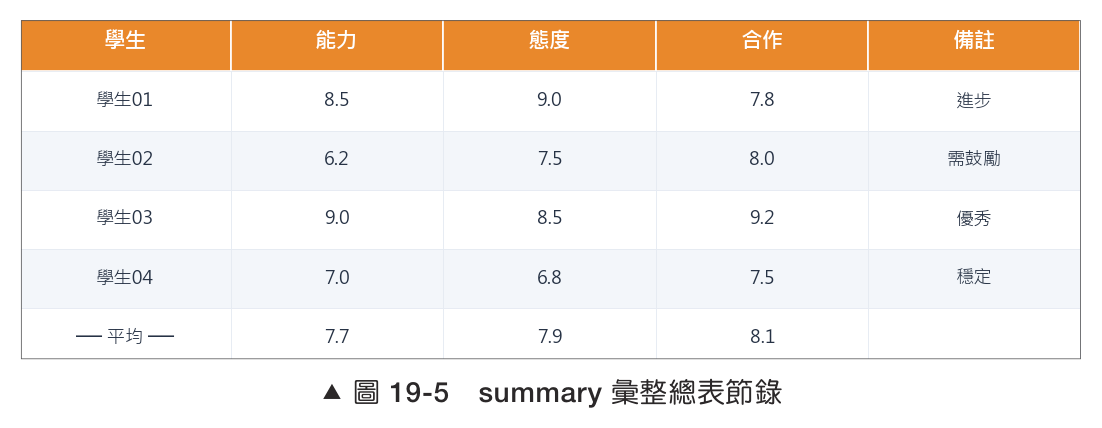
產出summary.xlsx:
請產 ~/batch-work/output/summary.xlsx:

欄位(每檔一列):
- 學生姓名(從檔名抓)
- 字數 / 強項 / 改進項
- 評語連結(指向 output 內的 .md)
- 處理時間(秒)
- 狀態(成功 / 失敗 + 原因)

加 Excel 篩選器:
- 可以篩「字數不足」
- 可以篩「需特別關注」
- 可以篩「狀態 = 失敗」
summary.xlsx長這樣:
| 姓名 | 字數 | 強項 | 改進項 | 評語連結 | 耗時 | 狀態 |
|---|---|---|---|---|---|---|
| 王小明 | 520 | 結構清楚 | 用詞貧乏 | 001_王小明_評語.md | 3.2 | 成功 |
| 李大華 | 380 | 敘事生動 | 字數不足 | 002_李大華_評語.md | 2.8 | 成功 |
| 008_格式怪 | - | - | - | - | - | 失敗 |
老師/主管1分鐘看完全部處理結果。
3種行業版本:批次處理發票、履歷、合約
SOHO版:50份發票OCR
| 項目 | 怎麼改 |
|---|---|
| 輸入 | 50張發票.jpg / .png |
| 單檔動作 | OCR萃取「金額、日期、發票號、品名」 |
| 輸出 | 每張一個.json + 統合invoices.xlsx |
| 套件 | Pillow + pytesseract(或請Codex用視覺辨識) |
Codex可直接讀圖(在對話內attach圖檔當輸入),不一定要本機跑tesseract。歪斜、低解析的手機翻拍照,傳統OCR常吃鱉,先拿3張試Codex視覺辨識,跟pytesseract結果比一比,再決定整批走哪條路。
【注意】要走pytesseract路線,得先另裝Tesseract本體
pip install pytesseract只裝了Python的橋接層,真正做OCR的Tesseract引擎要另外安裝(Windows下載官方安裝檔、macOS brew install tesseract、Linux apt install tesseract-ocr),還要加裝繁中語言包chi_tra。嫌麻煩就直接走Codex視覺辨識,省掉這一整串安裝。
HR版:200份履歷篩選
| 項目 | 怎麼改 |
|---|---|
| 輸入 | 200份履歷.pdf |
| 單檔動作 | CoT + 評分Skill(5維評分 + 一句評語) |
| 輸出 | 每份一個.md + summary(通過/待面試/不通過) |
| 並行 | 建議4-8(pypdf解析PDF慢) |
履歷含個資:用Codex評分時,履歷內容會送交OpenAI處理,不是純本機。先去識別化(遮掉姓名、電話、地址、身分證)再丟給Codex;要完全不外傳,就用Codex寫好的評分腳本自己在本機跑,並跑完刪對話歷史。
律師版:50份合約找風險
| 項目 | 怎麼改 |
|---|---|
| 輸入 | 50份合約.pdf |
| 單檔動作 | 三段CoT找風險條款(保密、違約、解約、智財權) |
| 輸出 | 每份一份風險摘要.md + 整體評估表.xlsx |
| 並行 | 2-4(保守,合約敏感寧可慢不要錯) |
| 隱私 | 合約內容會經OpenAI,走Business / Enterprise方案(資料不作訓練、可簽DPA);極機密改用組織核可的離線工具,或先去識別化再跑 |
節錄自:博碩文化《ChatGPT × Codex全攻略:從零基礎到自動化,打造你的AI Agent工作流》/曾慶良(阿亮老師) 著
